TP24 : Données et reprise après sinistre (CloudNativePG, Velero)
Les applications sans état se recréent en une commande ; les données, non. Ce TP traite deux questions que tout exploitant doit savoir résoudre : comment faire tourner une base PostgreSQL hautement disponible dans Kubernetes (avec l’opérateur CloudNativePG), et comment sauvegarder puis restaurer une base ou un namespace entier après un incident (archivage continu vers S3, restauration à un instant précis, Velero). Les sauvegardes sont stockées dans le S3 émulé par Floci (TP13).
Fichiers de départ :
manifests.zip,velero.zip
1. Objectifs pédagogiques
À l’issue du TP, vous serez capable de :
- expliquer ce qu’apporte un opérateur par rapport à un Deployment avec un PVC (TP14) ;
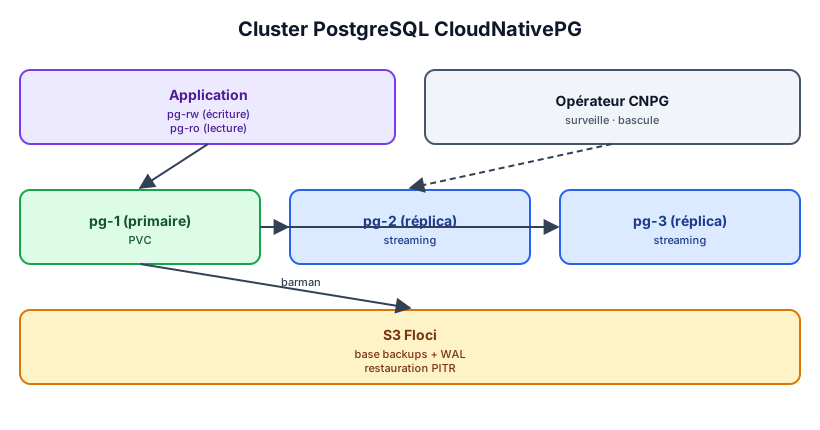
- déployer un cluster PostgreSQL primaire + réplicas avec CloudNativePG et provoquer une bascule (failover) ;
- configurer l’archivage continu (sauvegardes de base + WAL) vers S3 et réaliser une restauration PITR ;
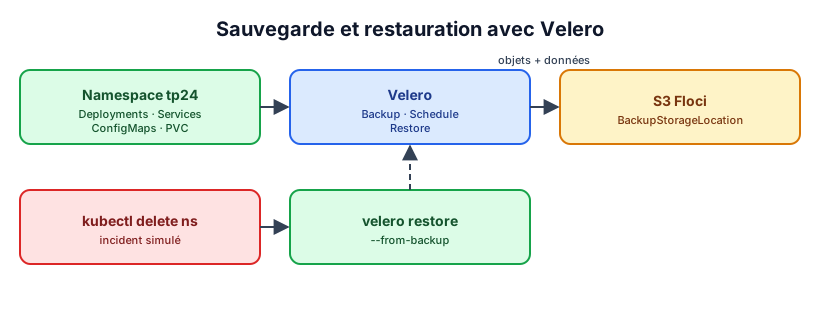
- sauvegarder et restaurer un namespace complet, volumes compris, avec Velero ;
- définir RPO et RTO et les mesurer.
Les images de cette page sont des schémas explicatifs, pas des captures d’écran.
2. Environnement du TP
-
Le cluster K3s du TP14 (≥ 3 Go de RAM libres), Helm (TP15) et cert-manager (TP16, requis par le plugin de sauvegarde).
-
Floci démarré sur la VM de lab et joignable depuis le cluster (
http://<IP-VM-lab>:4566), AWS CLI configuré (TP13). Créer les buckets :aws s3 mb s3://cnpg-backups && aws s3 mb s3://velero
| Terme | Signification |
|---|---|
| WAL | Write-Ahead Log : journal de toutes les modifications ; il permet de rejouer l’historique. |
| PITR | Point-In-Time Recovery : restauration à un instant précis (sauvegarde de base + WAL). |
| RPO | Recovery Point Objective : quantité maximale de données que l’on accepte de perdre. |
| RTO | Recovery Time Objective : durée maximale acceptable pour rétablir le service. |
3. Partie 1 : Cluster PostgreSQL avec CloudNativePG
-
Installer l’opérateur et le plugin
kubectl cnpg:helm repo add cnpg https://cloudnative-pg.github.io/charts && helm repo update helm install cnpg cnpg/cloudnative-pg -n cnpg-system --create-namespace curl -sSfL https://github.com/cloudnative-pg/cloudnative-pg/raw/main/hack/install-cnpg-plugin.sh | sudo sh -s -- -b /usr/local/bin -
Créer le cluster
10-cnpg-cluster.yamlet observer sa construction :kubectl apply -f manifests/10-cnpg-cluster.yaml kubectl -n tp24 get pods -w kubectl cnpg status pg -n tp24 kubectl -n tp24 get svc # pg-rw (primaire), pg-ro (réplicas), pg-r (tous) -
Se connecter avec l’utilisateur applicatif (mot de passe dans le Secret
pg-app), créer une tableorderset insérer quelques lignes :kubectl cnpg psql pg -n tp24 -- -c "CREATE TABLE orders(id serial primary key, item text, at timestamptz default now());" kubectl cnpg psql pg -n tp24 -- -c "INSERT INTO orders(item) VALUES ('clavier'),('écran');" -
Vérifier qu’une écriture sur un réplica est refusée (
pg-ro: cannot execute INSERT in a read-only transaction).
4. Partie 2 : Bascule automatique
-
Identifier le primaire (
kubectl cnpg status), puis le supprimer brutalement :kubectl -n tp24 delete pod pg-1 --grace-period=0 --force kubectl cnpg status pg -n tp24 -w -
Mesurer le temps d’indisponibilité en écriture (boucle d’
INSERTlancée avant la suppression) et vérifier qu’aucune donnée validée n’est perdue. -
Faire une bascule planifiée :
kubectl cnpg promote pg pg-3 -n tp24. -
Comparer avec le PostgreSQL « Deployment + PVC » du TP14 :
| Critère | Deployment + PVC | CloudNativePG |
|---|---|---|
| Réplication | ||
| Bascule en cas de panne | ||
| Sauvegardes et PITR | ||
| Mises à jour mineures | ||
| Complexité |
5. Partie 3 : Archivage continu vers S3 (Floci)
-
Installer le plugin Barman Cloud (voir la documentation CloudNativePG pour la version compatible avec votre opérateur) :
kubectl apply -f https://github.com/cloudnative-pg/plugin-barman-cloud/releases/latest/download/manifest.yaml kubectl -n cnpg-system rollout status deploy/barman-cloud -
Créer le Secret d’accès à Floci, compléter
20-objectstore.yaml(IP de la VM de lab) et activer le plugin dans le Cluster (blocplugins) :kubectl -n tp24 create secret generic floci-creds --from-literal=ACCESS_KEY_ID=test --from-literal=ACCESS_SECRET_KEY=test kubectl apply -f manifests/20-objectstore.yaml -f manifests/10-cnpg-cluster.yaml kubectl -n tp24 get backup aws s3 ls s3://cnpg-backups/ --recursive | head -
Ajouter une
ScheduledBackupquotidienne.
6. Partie 4 : Restauration à un instant précis (PITR)
- Noter l’heure exacte (
date -u '+%Y-%m-%d %H:%M:%S+00'), puis simuler une erreur humaine :DROP TABLE orders;. - Compléter
30-restore-cluster.yaml.exampleavec untargetTimeantérieur auDROP, créer le clusterpg-restored, puis vérifier que la table et ses lignes sont revenues. - Calculer le RPO obtenu (dernière donnée récupérée) et le RTO (durée de la restauration).
7. Partie 5 : Sauvegarder un namespace avec Velero
-
Installer la CLI Velero (releases) et déployer Velero avec le plugin AWS vers Floci (choisir la version du plugin compatible dans la matrice de compatibilité de Velero). L’option
--use-node-agentactive la sauvegarde des volumes au niveau fichiers (Kopia), nécessaire carlocal-pathne gère pas les snapshots :cp velero/credentials-velero.example velero/credentials-velero velero install --provider aws --plugins velero/velero-plugin-for-aws:<version> \ --bucket velero --secret-file ./velero/credentials-velero \ --backup-location-config region=us-east-1,s3ForcePathStyle="true",s3Url=http://<IP-VM-lab>:4566 \ --use-volume-snapshots=false --use-node-agent --default-volumes-to-fs-backup velero backup-location get # Available -
Déployer
40-app-to-backup.yaml, écrire un fichier dans le volume (kubectl -n tp24-app exec deploy/web -- sh -c 'date > /data/preuve.txt'), puis sauvegarder :velero backup create app-1 --include-namespaces tp24-app --wait velero backup describe app-1 --details -
Sinistre :
kubectl delete namespace tp24-app. Puis restaurer et vérifier que le Deployment, la ConfigMap, le PVC et le fichierpreuve.txtsont revenus :velero restore create --from-backup app-1 --wait kubectl -n tp24-app exec deploy/web -- cat /data/preuve.txt -
Planifier une sauvegarde quotidienne conservée 7 jours :
velero schedule create daily --schedule "0 2 * * *" --include-namespaces tp24-app --ttl 168h. -
Pourquoi sauvegarder séparément la base avec CloudNativePG plutôt que de compter uniquement sur Velero pour son volume ?
Défi
- Restaurer la sauvegarde Velero dans un autre namespace (
--namespace-mappings tp24-app:tp24-app-copy) pour un test de restauration sans toucher à la production.- Écrire un plan de reprise d’une page (scénarios, RPO/RTO visés, procédures, responsables) et le tester en chronométrant chaque étape.
8. Livrables
Captures à déposer dans captures/ :
| Fichier | Contenu attendu |
|---|---|
cnpg-status.png |
kubectl cnpg status : primaire et deux réplicas |
cnpg-failover.png |
Nouveau primaire après suppression de l’ancien |
cnpg-backup-s3.png |
Backup terminé et fichiers dans s3://cnpg-backups |
cnpg-pitr.png |
Table orders retrouvée dans pg-restored |
velero-restore.png |
Namespace supprimé puis restauré, fichier preuve.txt présent |
Ainsi que les manifests complétés, le tableau comparatif et les mesures RPO / RTO.