TP21 : Observabilité (Prometheus, Grafana, Loki, Tempo, OpenTelemetry, SLO)
Surveiller (monitoring) répond à « est-ce que ça marche ? ». L’observabilité permet de répondre à « pourquoi ça ne marche pas ? », y compris pour une panne jamais vue, grâce à trois signaux reliés entre eux : les métriques (combien, à quelle vitesse), les logs (ce qui s’est passé) et les traces (le parcours d’une requête à travers les services). Ce TP instrumente une petite application et monte la pile open source de référence : Prometheus + Grafana + Loki + Tempo + OpenTelemetry, puis définit un SLO et l’alerte associée.
Fichiers de départ :
demo-app.zip,k8s.zip,runbook-template.md,values.zip
1. Objectifs pédagogiques
À l’issue du TP, vous serez capable de :
- installer kube-prometheus-stack et lire les dashboards du cluster ;
- exposer des métriques applicatives avec prom-client et les faire collecter par un ServiceMonitor ;
- écrire des requêtes PromQL (taux, ratio d’erreurs, percentile de latence) et un dashboard Grafana ;
- centraliser les logs avec Loki + Grafana Alloy et les interroger en LogQL ;
- tracer les requêtes avec OpenTelemetry et Tempo, et passer d’un log à sa trace ;
- définir SLI, SLO, budget d’erreur, écrire une alerte et son runbook.
Les images de cette page sont des schémas explicatifs, pas des captures d’écran.
2. Environnement du TP
-
Un cluster K3s (TP14) avec au moins 6 Go de RAM disponibles pour la pile d’observabilité (le plus simple : K3s mono-nœud sur une VM de lab de 16 Go),
kubectlet Helm. -
Construire l’image de
demo-app/et la rendre disponible au cluster, au choix :docker build -t <utilisateur>/observability-demo:1.0.0 demo-app && docker push <utilisateur>/observability-demo:1.0.0 # ou, sans registre, sur un K3s mono-nœud : docker save observability-demo:1.0.0 | sudo k3s ctr images import -Reconstruire l’image après chaque partie qui modifie le code (2 et 4), avec un nouveau tag.
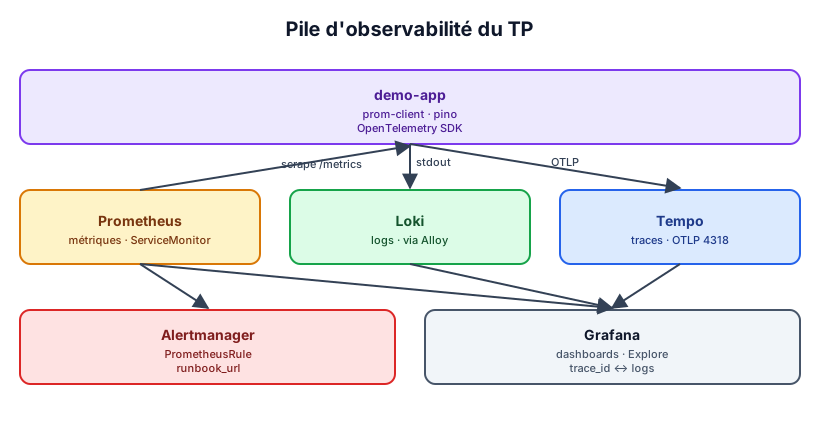
| Signal | Question | Outil du TP | Langage de requête |
|---|---|---|---|
| Métriques | Combien ? À quelle vitesse ? | Prometheus | PromQL |
| Logs | Que s’est-il passé ? | Loki (+ Alloy) | LogQL |
| Traces | Où le temps est-il passé ? | Tempo (+ OpenTelemetry) | TraceQL |
| Visualisation et alertes | — | Grafana, Alertmanager | — |
3. Partie 1 : kube-prometheus-stack
-
Installer la pile (Prometheus Operator, Prometheus, Alertmanager, Grafana, node-exporter, kube-state-metrics) avec les valeurs de
values/kube-prometheus-stack.yaml(changer le mot de passe Grafana) :helm repo add prometheus-community https://prometheus-community.github.io/helm-charts helm repo add grafana https://grafana.github.io/helm-charts && helm repo update helm install kps prometheus-community/kube-prometheus-stack -n monitoring --create-namespace \ -f values/kube-prometheus-stack.yaml kubectl -n monitoring get pods kubectl -n monitoring port-forward svc/kps-grafana 3000:80 --address 0.0.0.0 & -
Dans Grafana (
http://<IP-VM-lab>:3000), ouvrir les dashboards Kubernetes / Compute Resources / Namespace (Pods) et Node Exporter / Nodes : relever CPU, mémoire, nombre de Pods et redémarrages. -
Dans Explore → Prometheus, tester :
up,kube_pod_container_status_restarts_total,sum by (namespace) (container_memory_working_set_bytes).
4. Partie 2 : Métriques applicatives
-
Compléter le
TODOdedemo-app/src/server.js: métriques par défaut, histogrammehttp_request_duration_seconds(labelsmethod,route,status_code) et route/metrics.Cardinalité : n’utilisez jamais une valeur libre (identifiant utilisateur, URL complète avec paramètres) comme label. Chaque combinaison de labels crée une série temporelle.
-
Déployer l’application (
k8s/app.yaml, en remplaçant l’image), compléter et appliquerk8s/servicemonitor.yaml, puis vérifier la cible dans Prometheus (Status → Targets) :kubectl -n monitoring port-forward svc/kps-kube-prometheus-stack-prometheus 9090 & -
Générer du trafic :
kubectl -n tp21 run load --image=busybox:1.37 --restart=Never -- sh -c \ 'while true; do wget -qO- http://demo/ >/dev/null; wget -qO- http://demo/api/orders >/dev/null; wget -qO- http://demo/slow >/dev/null; sleep 0.2; done' -
Écrire les requêtes PromQL suivantes et en faire un dashboard Grafana « demo » (variables
routecomprises) :
| Panneau | Requête à écrire |
|---|---|
| Requêtes par seconde | sum by (route) (rate(http_request_duration_seconds_count[1m])) |
| Taux d’erreur (%) | ratio des status_code=~"5.." sur le total |
| Latence p50 / p95 / p99 | histogram_quantile(0.95, sum by (le) (rate(..._bucket[5m]))) |
| Mémoire des Pods | container_memory_working_set_bytes{namespace="tp21"} |
| Redémarrages | kube_pod_container_status_restarts_total{namespace="tp21"} |
5. Partie 3 : Logs avec Loki et Alloy
-
Installer Loki (mode monolithique) puis Alloy :
helm install loki grafana/loki -n monitoring -f values/loki.yaml helm install alloy grafana/alloy -n monitoring -f values/alloy.yaml -
Dans Explore → Loki, interroger les logs de l’application :
{namespace="tp21", app="demo"} {namespace="tp21"} | json | res_statusCode >= 500 sum by (pod) (count_over_time({namespace="tp21"} |= "échec simulé" [5m])) -
Retrouver tous les logs d’une requête à partir de son
x-request-id(le correlation ID déjà généré par l’application) :kubectl -n tp21 run curl --rm -it --image=curlimages/curl:8.15.0 --restart=Never -- -si http://demo/api/orders
6. Partie 4 : Traces avec OpenTelemetry et Tempo
-
Installer Tempo :
helm install tempo grafana/tempo -n monitoring -f values/tempo.yaml -
Compléter
demo-app/src/tracing.js(SDK Node, exporteur OTLP HTTP, instrumentation automatique), reconstruire l’image et redéployer. La variableOTEL_EXPORTER_OTLP_ENDPOINTdu Deployment pointe déjà vers Tempo. -
Appeler
/api/checkout(appel HTTP sortant vers/slow) puis, dans Explore → Tempo, ouvrir une trace : identifier le span serveur Express et le span client HTTP enfant, et leurs durées. -
Rechercher les traces lentes ou en erreur avec TraceQL :
{ resource.service.name = "observability-demo" && duration > 1s } { status = error } -
Corrélation : ajouter le
trace_iddans les logs (bonus duTODO), puis, depuis une trace dans Grafana, cliquer sur Logs for this span pour afficher les logs correspondants dans Loki.
7. Partie 5 : SLI, SLO, alerte et runbook
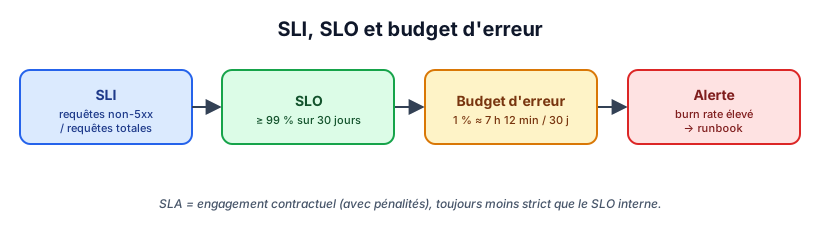
| Terme | Définition | Exemple |
|---|---|---|
| SLI | Indicateur mesuré du niveau de service | part de requêtes non-5xx |
| SLO | Objectif interne sur ce SLI, sur une période | ≥ 99 % sur 30 jours |
| Budget d’erreur | Ce que le SLO autorise à échouer | 1 % des requêtes |
| SLA | Engagement contractuel envers un client, avec pénalités | 98 %, remboursement sinon |
- Appliquer
k8s/prometheusrule.yaml: la règle d’enregistrementdemo:availability:ratio_rate5mcalcule le SLI. Compléter l’alerteDemoAvailabilitySLOBreach(SLI < 0,99 pendant 5 min). - Rédiger le runbook à partir de
runbook-template.mdet mettre son lien dansrunbook_url. - Provoquer l’incident :
kubectl -n tp21 set env deploy/demo ERROR_RATE=0.3, puis suivre l’alerte dans Prometheus (Alerts :pendingpuisfiring) et dans Alertmanager (kubectl -n monitoring port-forward svc/kps-kube-prometheus-stack-alertmanager 9093). - Mener le diagnostic en suivant le runbook (métriques → logs → traces), puis rétablir
ERROR_RATE=0.05et observer la résolution de l’alerte. - Calculer : avec un SLO de 99 % sur 30 jours, combien de minutes d’indisponibilité totale le budget d’erreur autorise-t-il ? Et avec 99,9 % ?
Défi
- Remplacer l’alerte à seuil par une alerte multi-window, multi-burn-rate (fenêtres 1 h / 5 min et 6 h / 30 min) comme recommandé par le Google SRE Workbook.
- Configurer Alertmanager pour envoyer les alertes vers un webhook de test (par exemple un conteneur
mendhak/http-https-echo) et afficher le JSON reçu.
8. Livrables
Captures à déposer dans captures/ :
| Fichier | Contenu attendu |
|---|---|
cluster-dashboard.png |
Dashboard Kubernetes : CPU, mémoire, Pods, redémarrages |
target-up.png |
Cible demo à l’état UP dans Prometheus |
demo-dashboard.png |
Dashboard « demo » : débit, erreurs, latences p50 / p95 / p99 |
loki-logql.png |
Logs filtrés par LogQL et par x-request-id |
tempo-trace.png |
Trace /api/checkout avec span serveur et span client |
trace-to-logs.png |
Passage d’une trace à ses logs |
slo-alert-firing.png |
Alerte DemoAvailabilitySLOBreach en état firing |
Ainsi que : le code instrumenté, les manifests, l’export JSON du dashboard « demo » et le runbook rempli.