TP14 : Kubernetes avec K3s (cluster, objets de base, configuration, santé, stockage)
Kubernetes orchestre des conteneurs sur un ensemble de machines : il les démarre, les redémarre, les répartit, les expose et les met à l’échelle à partir d’un état désiré décrit en YAML. K3s est une distribution Kubernetes certifiée CNCF, légère (un seul binaire), idéale pour un lab : elle embarque containerd, CoreDNS, l’Ingress Traefik, un load balancer de service, le stockage local-path et metrics-server.
Ce TP réutilise Vagrant (TP5) et Ansible (TP4) pour monter un cluster à deux nœuds, puis fait découvrir les objets Kubernetes indispensables sur une application de démonstration (traefik/whoami).
Fichiers de départ :
k3s-lab.zip,k8s-starter.zip
1. Objectifs pédagogiques
À l’issue du TP, vous serez capable de :
- décrire l’architecture d’un cluster (control plane, nœuds, kubelet, API server, etcd/SQLite) ;
- installer un cluster K3s multi-nœuds de façon reproductible avec Vagrant + Ansible ;
- utiliser
kubectl(get,describe,logs,exec,apply,rollout,port-forward) ; - écrire Namespace, Deployment, Service, Ingress, ConfigMap, Secret, PVC et HPA ;
- configurer probes et requests / limits, et réaliser un rolling update et un rollback.
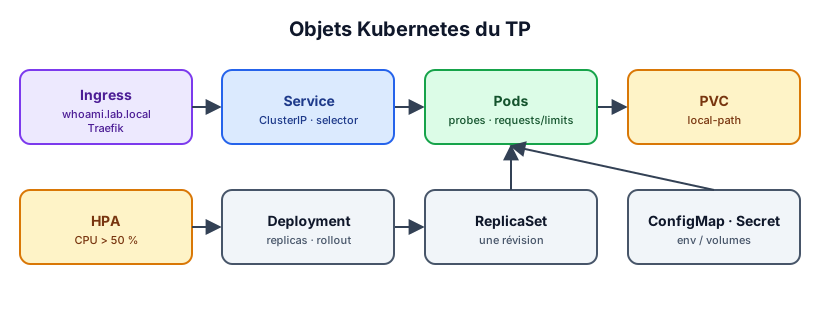
Les images de cette page sont des schémas explicatifs, pas des captures d’écran.
2. Environnement du TP
-
VM de lab Ubuntu Server 26.04 avec VirtualBox, Vagrant et Ansible (TP5), ≥ 4 vCPU et ≥ 8 Go de RAM, virtualisation imbriquée activée.
-
Installer
kubectlsur la VM de lab :curl -LO "https://dl.k8s.io/release/$(curl -Ls https://dl.k8s.io/release/stable.txt)/bin/linux/amd64/kubectl" sudo install -m 0755 kubectl /usr/local/bin/kubectl && kubectl version --client -
Ajouter dans
/etc/hostsde la VM de lab :192.168.56.10 whoami.lab.local.
Plan B si la RAM manque : installer K3s directement sur la VM de lab (
curl -sfL https://get.k3s.io | sh -). Les parties 2 à 7 fonctionnent à l’identique sur un nœud unique.
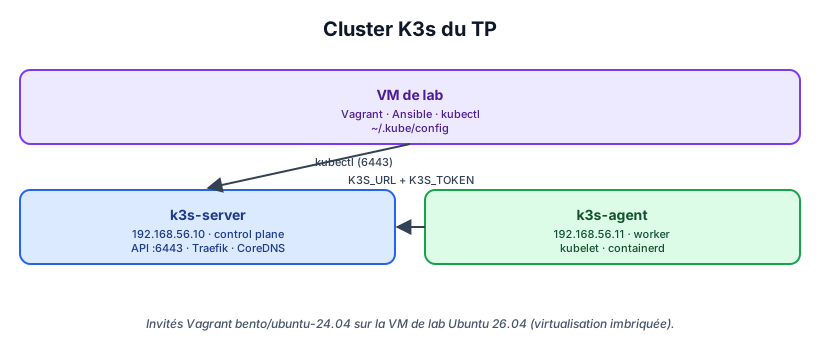
3. Partie 1 : Cluster K3s avec Vagrant + Ansible
-
Ouvrir
k3s-lab/Vagrantfile: deux VM, et Ansible lancé une seule fois après la dernière VM, sur tout le cluster. -
Compléter les
TODOdek3s-lab/playbook.yml:- installation idempotente du server (
creates: /usr/local/bin/k3s) avec--node-ip,--tls-sanet--write-kubeconfig-mode 644; - lecture du jeton du server (
slurp), puis installation de l’agent avecK3S_URLetK3S_TOKEN; - rapatriement du fichier
k3s.yamlsur la VM de lab, avec l’IP du server à la place de127.0.0.1.
- installation idempotente du server (
-
Créer le cluster et le vérifier :
cd k3s-lab && vagrant up mkdir -p ~/.kube && cp k3s.yaml ~/.kube/config && chmod 600 ~/.kube/config kubectl get nodes -o wide # 2 nœuds Ready kubectl get pods -A # coredns, traefik, local-path, metrics-server -
Transformer le playbook en rôle
k3s(roles/k3s/tasks/{server,agent}.yml,defaults/main.ymlavec la version de K3s épinglée viaINSTALL_K3S_VERSION). -
Détruire et recréer le cluster uniquement avec
vagrant destroy -f && vagrant up. Noter le temps nécessaire.
| Composant | Rôle |
|---|---|
| API server | Point d’entrée unique : kubectl et tous les composants lui parlent. |
| Datastore | État du cluster (SQLite par défaut avec K3s, etcd en haute disponibilité). |
| Scheduler | Choisit le nœud de chaque Pod selon les ressources demandées. |
| Controllers | Boucles qui rapprochent l’état réel de l’état désiré (ReplicaSet, Deployment…). |
| kubelet | Agent de chaque nœud : démarre les conteneurs via containerd. |
4. Partie 2 : Pods et Deployments
-
Lancer un Pod « à la main » puis le supprimer : est-il recréé ? Pourquoi ?
kubectl run test --image=traefik/whoami:v1.10.0 kubectl get pods -o wide && kubectl delete pod test -
Appliquer le Namespace et le Deployment de
k8s-starter/:kubectl apply -f k8s-starter/01-namespace.yaml -f k8s-starter/03-deployment.yaml kubectl -n tp14 get deploy,rs,pods -o wide -
Supprimer un Pod du Deployment et observer sa recréation (
kubectl -n tp14 get pods -w). Sur quels nœuds sont répartis les Pods ? -
Explorer :
kubectl describe pod,kubectl logs,kubectl exec -it … -- sh(l’imagewhoamin’a pas de shell : que se passe-t-il ?),kubectl explain deployment.spec.strategy.
5. Partie 3 : Services et Ingress
-
Compléter le
selectorde04-service.yaml, appliquer, puis vérifier les endpoints :kubectl -n tp14 get svc,endpointslices kubectl -n tp14 port-forward svc/whoami 8080:80 & curl -s localhost:8080 | grep Hostname # relancer : le Pod change -
Tester la résolution DNS interne depuis un Pod temporaire :
kubectl -n tp14 run tmp --rm -it --image=busybox:1.37 --restart=Never -- \ wget -qO- http://whoami.tp14.svc.cluster.local -
Appliquer
05-ingress.yamlpuiscurl http://whoami.lab.local. Compléter leTODO: un Deployment + Servicenginxservi sous/api.
| Type de Service | Accès |
|---|---|
ClusterIP |
Interne au cluster uniquement (par défaut). |
NodePort |
Port 30000–32767 ouvert sur chaque nœud. |
LoadBalancer |
IP externe (fournie par ServiceLB sur K3s, par le cloud ailleurs). |
| Ingress | Routage HTTP par nom d’hôte et chemin vers des Services ClusterIP. |
6. Partie 4 : ConfigMap et Secret
-
Appliquer
02-config.yamlet créer le Secret en ligne de commande (il ne doit pas être versionné) :kubectl -n tp14 create secret generic whoami-secret --from-literal=api-key='lab-only-value' kubectl -n tp14 get secret whoami-secret -o yaml # la valeur est en base64 echo '<valeur>' | base64 -d # base64 n'est PAS du chiffrement -
Injecter la ConfigMap (
envFrom) et la clé du Secret (secretKeyRef) dans le Deployment, puis vérifier dans la page renvoyée parwhoami(variables d’environnement affichées avec?env=true). -
Modifier la ConfigMap : la valeur change-t-elle dans les Pods existants ? Que faut-il faire (
kubectl rollout restart) ?
7. Partie 5 : Santé, ressources et déploiements progressifs
-
Ajouter une
readinessProbeet unelivenessProbeHTTP sur/health, ainsi que desrequests/limits. -
Simuler une panne :
whoamipermet de forcer le code de/health:kubectl -n tp14 port-forward deploy/whoami 8081:8080 & curl -X POST -d '500' localhost:8081/health kubectl -n tp14 get pods -w # le Pod sort des endpoints puis redémarre (RESTARTS) -
Réaliser un rolling update puis un rollback :
kubectl -n tp14 set image deploy/whoami whoami=traefik/whoami:v1.10.1 kubectl -n tp14 rollout status deploy/whoami kubectl -n tp14 set image deploy/whoami whoami=traefik/whoami:v9.9.9 # image inexistante kubectl -n tp14 get pods # ImagePullBackOff, l'ancienne version reste servie kubectl -n tp14 rollout history deploy/whoami kubectl -n tp14 rollout undo deploy/whoami -
Expliquer pourquoi le service n’a jamais été interrompu (
maxUnavailable,maxSurge, readinessProbe). -
Mettre un
limits.memorytrès bas (4Mi) : observer l’étatOOMKilledaveckubectl describe pod.
8. Partie 6 : Stockage persistant
- Créer le Secret
postgres-secret, compléter le montage du PVC dans06-postgres.yamlet appliquer. - Créer une table et y insérer une ligne (
kubectl exec -it deploy/postgres -- psql -U postgres), supprimer le Pod, puis vérifier que la donnée est toujours là. kubectl get pv,pvc -n tp14: où sont physiquement stockées les données aveclocal-path? Quelle limite cela pose-t-il si le Pod change de nœud ?
9. Partie 7 : HorizontalPodAutoscaler
-
Vérifier
metrics-server(kubectl top nodes,kubectl top pods -n tp14), puis appliquer07-hpa.yaml. -
Générer de la charge et observer la montée puis la descente du nombre de replicas :
kubectl -n tp14 run load --rm -it --image=busybox:1.37 --restart=Never -- \
  sh -c 'while true; do wget -qO- http://whoami >/dev/null; done'
kubectl -n tp14 get hpa -w
Défi
- Ajouter un troisième nœud au cluster en ne modifiant que le tableau
NODESduVagrantfile, puiskubectl drainun nœud et observer le déplacement des Pods.- Ajouter un PodDisruptionBudget (
minAvailable: 1) et vérifier qu’il bloque undrainqui supprimerait tous les Pods.
10. Livrables
Captures à déposer dans captures/ :
| Fichier | Contenu attendu |
|---|---|
cluster-nodes.png |
kubectl get nodes -o wide (2 nœuds Ready) et get pods -A |
rebuild.png |
Cluster recréé avec vagrant destroy -f && vagrant up |
ingress.png |
curl http://whoami.lab.local et /api |
probes-restart.png |
Pod redémarré par la livenessProbe |
rollout-undo.png |
rollout history puis rollout undo après l’image inexistante |
pvc-persistence.png |
Donnée conservée après suppression du Pod PostgreSQL |
hpa.png |
kubectl get hpa -w montrant la mise à l’échelle |
Ainsi que : Vagrantfile, rôle Ansible k3s, manifests complétés. Pas de k3s.yaml (kubeconfig) ni de Secret dans Git.